
Stockroom
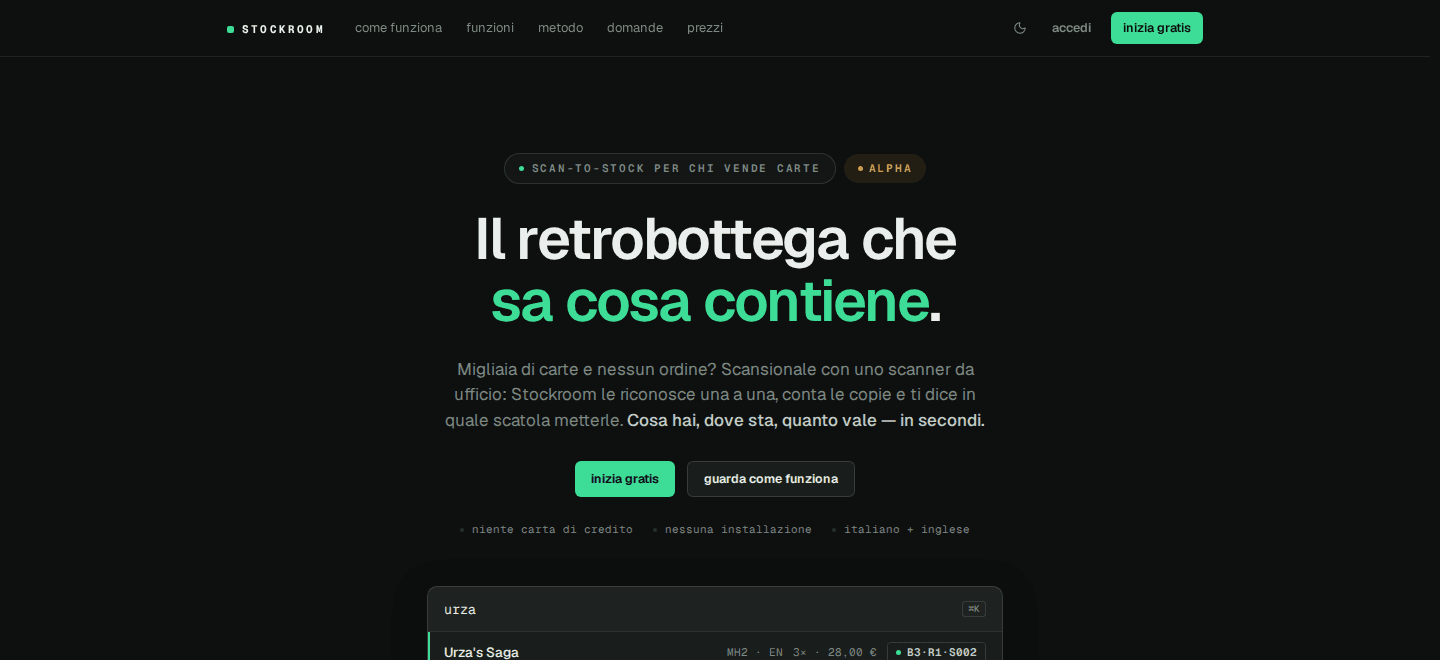
Stockroom è un gestionale di magazzino per negozi di carte collezionabili, online in alpha e per ora dedicato a Magic: The Gathering. Il negozio scansiona il bulk con lo scanner che ha già, trascina le immagini nel browser, e Stockroom riconosce ogni carta, conta le copie e le assegna a uno scaffale.
Apri stockroom.gg ↗- carte risolte nel primo test in produzione
- 112/113
- ricerca vettoriale dopo una correzione alla query
- 2 s → 1,6 ms
- costo stimato ogni 1.000 carte
- < 2 €
Il problema
Un negozio che compra bulk non sa davvero cosa possiede né dove sta. Catalogare a mano migliaia di carte richiede ore ogni mille, quindi nessuno lo fa, e quando un cliente chiede una carta la risposta è "forse, ripassa domani".
Tre passaggi, prima il più economico
Il browser ritaglia ogni carta e legge con l'OCR la riga stampata in basso, codice del set e numero di collezione, così il primo passaggio sul server non costa niente. Se la riga si legge, la carta si trova con una semplice ricerca.
Se non si legge, un embedding dell'immagine viene confrontato con circa 106.000 stampe in Postgres con pgvector. Un risultato netto viene accettato. Quando due stampe sono vicine, l'operatore sceglie tra due o tre candidati.
Solo quello che resta va a un modello linguistico, che può scegliere solo da quella lista chiusa di candidati. Non inventa mai una carta. Se il modello viene spento il lavoro non si ferma, l'operatore sceglie un po' più spesso. La stessa pipeline è nata su Dashi, dove aveva già elaborato circa 25.000 carte.
Onesti sull'accuratezza
I negozi scansionano da soli, quindi nessuno conosce la risposta giusta per ogni carta e l'accuratezza top-1 non si può misurare davvero. L'obiettivo che ho scelto è qualcosa che un negozio sente: l'operatore deve toccare meno di una riga su cinque. Ogni correzione viene salvata, così gli errori diventano un dataset etichettato su cui tarare le soglie.
Mille volte più veloce
All'inizio la ricerca per similarità richiedeva circa due secondi, con picchi di dieci. La query era scritta in un modo che saltava l'indice vettoriale e scorreva tutto il catalogo. Riscritta per ordinare sulla distanza, la stessa ricerca richiede 1,6 ms a cache calda, e il recall è rimasto lo stesso.
Stack
Next.js · Postgres · pgvector · Drizzle · Better Auth · tesseract.js · AI SDK